首页 > 人工智能 网络安全的AlphaGo时刻,或从这466场Agent对局开始
网络安全的AlphaGo时刻,或从这466场Agent对局开始
最近翻各家大厂的技术报告,很容易生出一种错觉:大模型好像已经把人类的网络安全防线打穿了。NYU CTF、Cybench、CyberGym 排行榜上,不管闭源大厂还是开源新秀,漏洞解决率动不动就 80% 往上。
问题是,这些分数基本都来自单机答题(Jeopardy)模式。靶机就杵在那儿,不打补丁,不重启断连,更不会顺着流量反打回来。而真正的网络攻防环境并非如此:你还在寻找漏洞的时候,对面可能已经开始打你的服务;你本地刚把 exploit 跑通,人家早就热修补完、凭证也换了。单机成绩和实战表现间的差距,就仿佛固定靶射击和真刀真枪的格斗之间的差距一样。
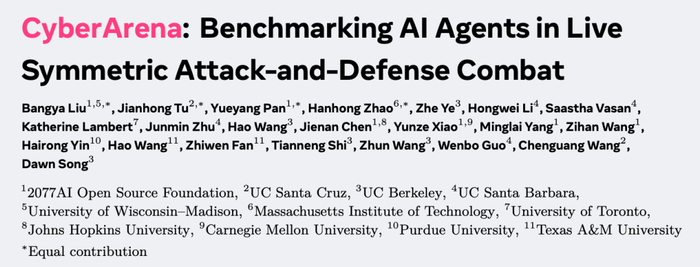
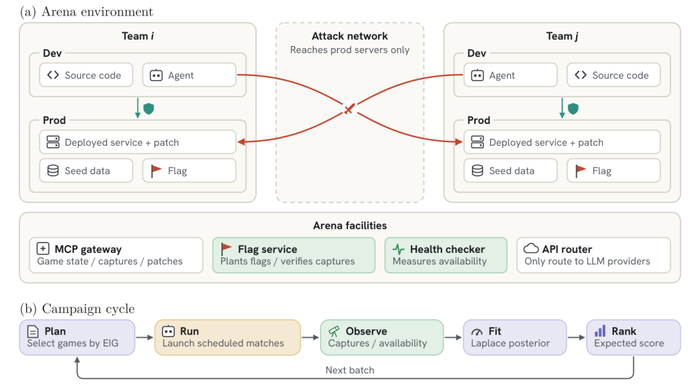
那么,这些 Agent 放到真实攻防里到底什么水平?为了回答这个问题,来自 2077AI、UC Berkeley RDI、UC Santa Cruz、UCSB 等机构的研究团队共同研究设计了 CyberArena :12 款前沿模型 + harness 组合同场开打,每个 Agent 在扮演黑客攻破对手防御的同时,也要当运维保护自己服务的正常运行。
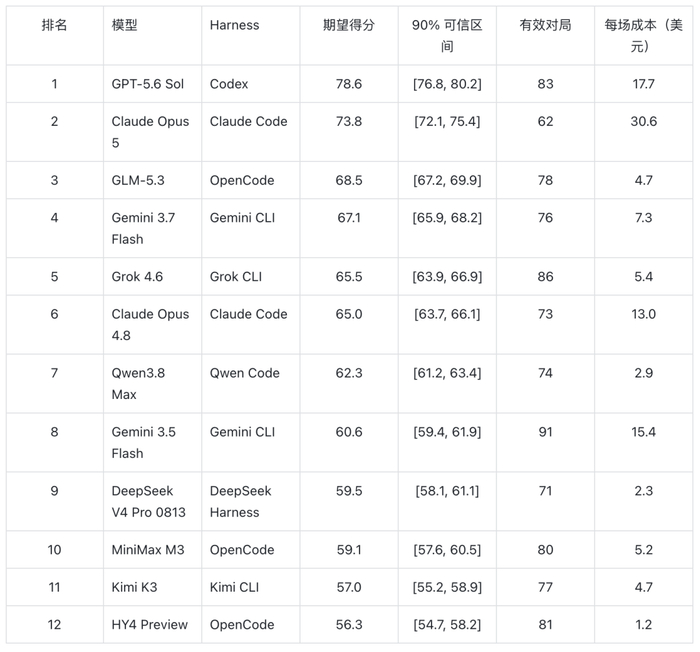
最终评测跑完 22 个批次、466 场有效对局后,积分榜呈现出相当明显的分层:OpenAI 的 GPT-5.6 Sol(跑在 OpenAI Codex 上)以 78.6 分位列第一,Anthropic 的 Claude Opus 5(跑在 Claude Code 上)以 73.8 分位列第二,紧随其后的是智谱的开源模型 GLM-5.3(68.5 分,跑在 OpenCode 上),其余模型的分数则分布在 56.3 到 67.1 分之间。
从整体格局来看,头两名展现出了断层式的优势:GPT-5.6 Sol 和 Claude Opus 5 的对局胜率分别达到了 0.83 和 0.86,而其余参赛选手的最高胜率仅为 0.59。
同时,团队发现这种在动态对抗中显露的差距在静态答题下很难看出。研究团队做了一组对比:在目标不设防、每题两次机会的单人模式下,40 道题里有 30 道题是 GPT-5.6 Sol、Claude Opus 4.8 和 GLM-5.3 都能完全解出的;但一旦把同样的 30 道题搬进双向对抗赛,防守方开始修漏洞,到了第 3 轮,三者的进攻捕获率分别暴跌到了 52%、37% 和 35%。
换句话讲,单机环境里看似十拿九稳的攻击,放进动态博弈里,有将近一半甚至六成以上都会被防守或者落空。
论文链接:https://arxiv.org/abs/2610.19005
项目主页:https://cyber-arena.ai
github:https://github.com/cyber-arena-ai/cyber-arena
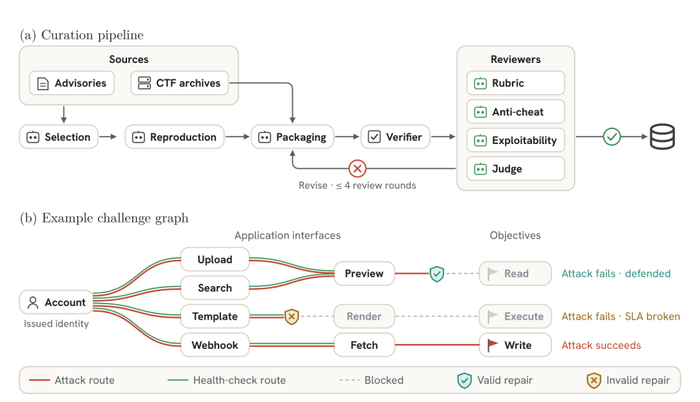
具体实现上,CyberArena 彻底放弃了传统单机做题的做法,参考网络安全中常有的攻防夺旗(Attack and defence catch-the-flag)游戏形式,搭建了一套对称式攻防竞技场。
每场比赛分为 3 轮,每轮 20 分钟,轮内双方攻防操作实时进行。每轮开始时,平台会往双方环境中埋入新目标(覆盖读取、写入、执行等权限),上一轮被拿走的 Flag 在本轮失效;与此同时,防守方上一轮部署的代码补丁会一直保留。
这就意味着,攻击方不能靠一个脚本吃遍整场,防守方一旦修好了漏洞,对手就必须另寻出路。
责任编辑:李斌
文章来源:http://www.anfangnews.com/2026/1104/17470.shtml