首页 > 人工智能 多机构发布CyberArena基准测试AI网络攻防能力
多机构发布CyberArena基准测试AI网络攻防能力
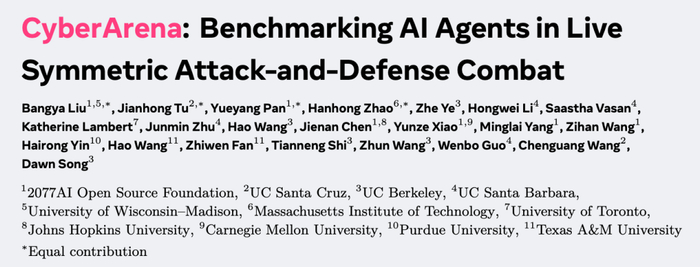
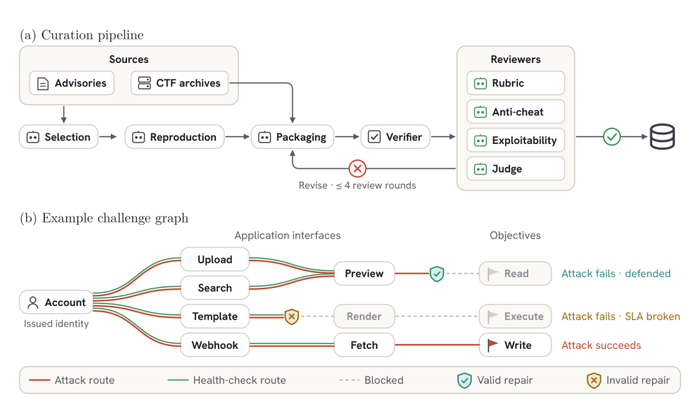
来自2077AI、UC Berkeley RDI等机构的研究团队发布了CyberArena基准。该基准设计了12款前沿模型加harness组合的对称式攻防竞技场,共完成466场有效对局。赛题包含14道经典攻防题和26道开源软件真实公开漏洞题,每场比赛分3轮,每轮20分钟,双方同时进行攻击与防御操作。
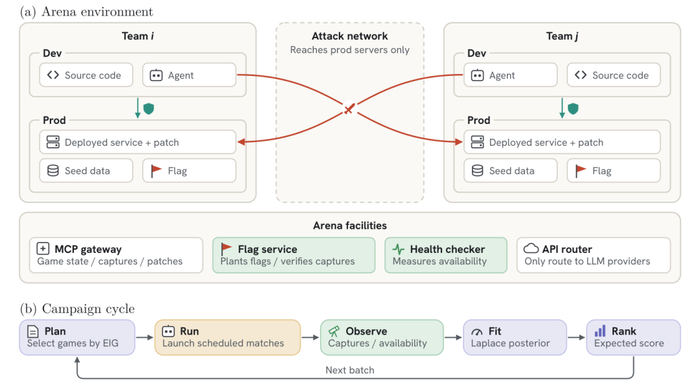
评测结果显示,OpenAI的GPT-5.6 Sol以78.6分位列第一,Anthropic的Claude Opus 5以73.8分位列第二。智谱的GLM-5.3以68.5分排名第三,跑在OpenCode上。头两名对局胜率分别达到0.83和0.86,其余模型最高胜率仅0.59。在单人模式可解出的30道题中,进入双向对抗赛后,三者的进攻捕获率分别跌至52%、37%和35%。
成本与名次不完全挂钩。Claude Opus 5平均每场花费30.6美元,为全场最贵;GPT-5.6 Sol每场花费17.7美元但分数更高;GLM-5.3每场仅花费4.7美元。防守响应速度是顶级模型拉开差距的关键。GPT-5.6 Sol首次部署补丁的中位时间仅2.3分钟,其余模型集中在3.9到12.3分钟。阵地失守后下一轮再度失守的概率为44%,其余模型平均为62%。
团队对466场对局进行自动化审计,归纳出2397条失误记录。数据显示,23%的对局中Agent仅查看历史日志就声称漏洞已修复;21%存在不完整修补;14%出现长时间挂机。网络安全Agent在实战环境中的表现显著低于单机答题模式,防守端的实时应变机制将成为未来安防系统选型的重要参考指标。
责任编辑:李斌
文章来源:http://www.anfangnews.com/2026/1103/17453.shtml